
一段凌晨三点的终端报错
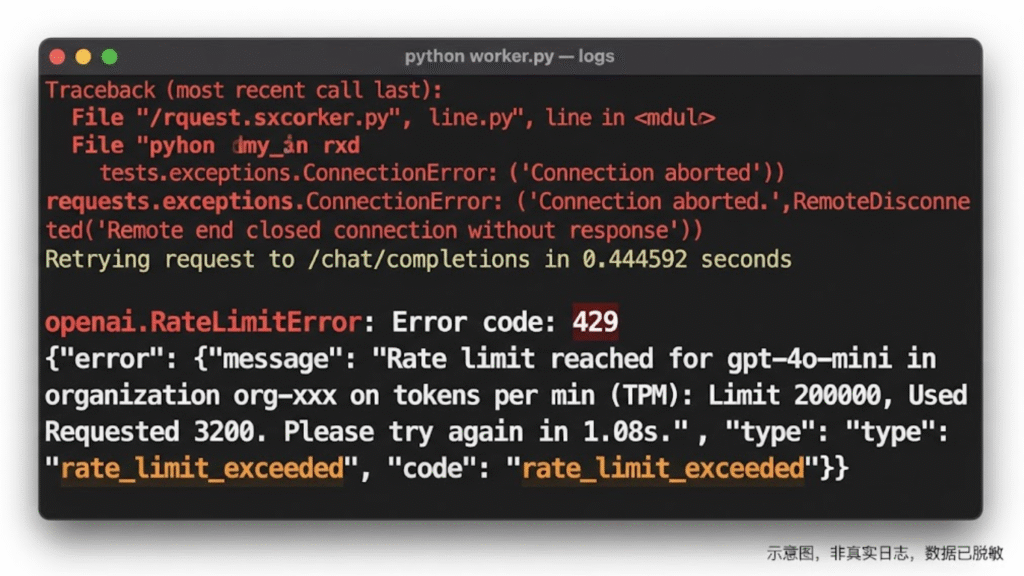
requests.exceptions.ConnectionError: (‘Connection aborted.’, RemoteDisconnected(‘Remote end closed connection without response’)),下方是 openai.RateLimitError: Error code: 429 - {‘error’: {‘message’: ‘Rate limit reached for gpt-4o-mini in organization org-xxx on tokens per min (TPM): Limit 200000, Used 198432, Requested 3200. Please try again in 1.08s.’, ‘type’: ‘tokens’, ‘code’: ‘rate_limit_exceeded’}}。红色堆栈,中间夹杂着 Retrying request to /chat/completions in 0.444592 seconds 的日志行。)
这是调用大模型 API 的团队几乎都见过的画面。业务量上来之后,限流和超时不再是个别请求的偶发问题,而是系统性故障的前兆。更危险的是,很多团队的第一反应是“加重试”——但如果重试逻辑写得不对,你会在几分钟内把剩余的配额烧光,甚至被上游临时封禁。
这篇文章拆解三类最常见的报错(429 限流、503/504 超时、Webhook 重复回调),给出可以直接落地的 Python / Node.js 代码,以及一个不会让情况变得更糟的重试策略。
先把报错拆开:429、503/504 和连接池耗尽,修法完全不同
把 429 和超时混为一谈,是排错时最常见的第一个错误。它们的根因和应对方式截然不同。
真实的 429(Too Many Requests) 有明确的特征:HTTP 状态码 429,响应头里带 Retry-After,响应体是 JSON,格式类似 {“error”: {“type”: “rate_limit_error”, ...}}。限流通常分两个维度:RPM(每分钟请求数) 和 TPM(每分钟 token 数)。大模型 API 的 TPM 限制尤其容易被忽视——一次长上下文请求可能瞬间吃掉几万 token,即使请求次数远未触顶,TPM 先爆了。
503 / 504(Service Unavailable / Gateway Timeout) 则完全是另一回事。503 通常是上游过载或维护,504 是你的客户端或中间网关在等待上游响应时超时。这类错误的共同点是没有业务语义上的“错误”,请求本身可能是合法的,只是没能在预期时间内拿到结果。
连接池耗尽是最隐蔽的一类。表现不是某个请求报 429,而是客户端开始出现 OSError: [Errno 24] Too many open files,或者请求在没有任何 HTTP 状态码的情况下直接失败。Linux 默认单进程文件描述符上限是 1024,高并发下每个未释放的 TCP 连接都会占用一个 fd,很快就会触顶。Python 里用 requests.get() 而不复用 Session、不显式关闭响应,是最常见的泄漏路径。
还有一个容易被误判的情况:网络层故障伪装成限流。如果你在中国大陆、东南亚或中东部分地区,requests.exceptions.ConnectionError 且响应体为空、ConnectionResetError、或者 SDK 抛出 APIConnectionError 而不是 RateLimitError,问题大概率出在 DNS 污染、ISP 路由或 TCP RST 注入,而不是你的配额。真正限流和网络故障的区分方式是:看响应体和响应头,不要只看异常类的字符串表示。
错误示范:为什么 while True: try... except: continue 会让情况变得更糟
在讲正确做法之前,先看一段很多人写过(包括我)的代码:
python
# 千万不要在生产环境使用
while True:
    try:
        response = client.chat.completions.create(...)
        break
    except Exception:
        continue
这段代码的问题不是“不优雅”,而是在限流场景下会主动制造一场小型 DDoS。当你收到 429 时,上游告诉你“现在太挤了,等一会儿”。不加任何延迟地立即重试,等于在一个已经饱和的队列上继续以最大速率灌入请求。更糟的是,如果多个客户端实例同时进入这个循环,它们会在同一时刻发起重试,形成 thundering herd(惊群效应) :所有失败者同时醒来、同时重试、再次同时失败,上游永远没有喘息窗口。
正确的重试必须同时满足三个条件:有上限、递增间隔、带随机抖动。只满足前两个还不够——如果所有客户端用的是完全相同的指数序列(1s, 2s, 4s, 8s),它们仍然会在相同的时刻碰撞。
生产级重试:指数退避 + 随机抖动
指数退避把重试间隔按 1s、2s、4s、8s 递增,给上游逐步恢复的时间;抖动在每次计算的间隔上叠加一个随机偏移,把原本同步的重试波峰打散。两者缺一不可。
Python:用 tenacity 一行解决,但要选对等待策略
tenacity 已经内置了 wait_exponential_jitter,不需要自己手写退避逻辑。
python
import httpx
from tenacity import (
    retry,
    stop_after_attempt,
    stop_after_delay,
    wait_exponential_jitter,
    retry_if_exception_type,
)

RETRYABLE_EXCEPTIONS = (
    httpx.ConnectTimeout,
    httpx.ReadTimeout,
    httpx.ConnectError,
)

@retry(
    retry=retry_if_exception_type(RETRYABLE_EXCEPTIONS),
    stop=stop_after_attempt(4) | stop_after_delay(30),
    wait=wait_exponential_jitter(initial=1, max=15),
    reraise=True,
)
def call_model_api(payload: dict) -> dict:
    with httpx.Client(timeout=httpx.Timeout(10.0, connect=5.0)) as client:
        response = client.post(
            "https://api.openai.com/v1/chat/completions",
            json=payload,
            headers={"Authorization": "Bearer ..."},
        )
        if response.status_code == 429:
            retry_after = response.headers.get("Retry-After")
            # tenacity 不会自动读 Retry-After,需要自定义等待时叠加
        response.raise_for_status()
        return response.json()
这里的 initial=1, max=15 意味着等待时间从 1 秒起步,指数递增但被截断在 15 秒,jitter 会在每次计算的间隔上加入随机分量。stop_after_attempt(4) | stop_after_delay(30) 同时限制了尝试次数和总耗时——只有次数上限是不够的,如果指数退避加上抖动后某次等待特别长,总耗时可能远超业务可接受的窗口。
如果你需要严格尊重上游返回的 Retry-After(当它大于计算出的退避间隔时),需要自定义等待策略,把 Retry-After 的值取出来并覆盖本次等待。tenacity 本身不内置这个逻辑,但可以在异常对象上挂载属性后在自定义 wait 函数里读取。
Node.js:axios-retry 的 exponentialDelay,以及一个手写版本
javascript
const axios = require('axios');
const axiosRetry = require('axios-retry').default;

const client = axios.create({ timeout: 10000 });

axiosRetry(client, {
  retries: 3,
  retryDelay: axiosRetry.exponentialDelay,
  retryCondition: (error) => {
    return (
      axiosRetry.isNetworkOrIdempotentRequestError(error) ||
      error.response?.status === 429 ||
      error.response?.status === 503 ||
      error.code === 'ECONNABORTED' ||
      error.code === 'ETIMEDOUT'
    );
  },
  shouldResetTimeout: true,
});
shouldResetTimeout: true 很关键:它让每次重试重新计算超时窗口,而不是让所有重试共享第一次请求的 deadline。error.code === ‘ECONNABORTED’ 是 axios 在请求超时时抛出的典型 code。
如果想完全控制退避和抖动,手写一个也不复杂:
javascript
function sleep(ms) {
  return new Promise((resolve) => setTimeout(resolve, ms));
}

async function withBackoff(fn, { attempts = 4, baseMs = 1000, maxMs = 15000 } = {}) {
  for (let i = 0; i < attempts; i++) {
    try {
      return await fn();
    } catch (err) {
      const isRetryable =
        err.code === 'ECONNABORTED' ||
        err.code === 'ETIMEDOUT' ||
        err.response?.status === 429 ||
        err.response?.status === 503 ||
        err.response?.status === 504;
      if (!isRetryable || i === attempts - 1) throw err;

      const exponential = Math.min(baseMs * 2 ** i, maxMs);
      const jitter = Math.random() * exponential * 0.5;
      await sleep(exponential + jitter);
    }
  }
}
2 ** i 产生 1x、2x、4x、8x 的指数增长,Math.random() * exponential * 0.5 在每次等待上叠加最多 50% 的随机偏移。不要用固定偏移(比如每次都加 500ms) ,固定偏移在大量客户端同时失败时仍然会产生重叠波峰。
防止重复扣费:幂等性不是“加个锁”那么简单
重试解决的是“请求可能失败”,但重试本身引入了一个新问题:如果第一次请求实际上已经在服务端成功了,只是响应在返回途中超时,客户端重试会导致同一笔操作被执行两次。对于调用大模型 API 按 token 计费、或者涉及支付回调的场景,这意味着真金白银的双重扣费。
Idempotency-Key:让服务端识别“这是同一次操作”
幂等性的核心是让客户端在第一次发送之前就生成一个唯一键,后续所有重试都携带同一个键。服务端收到请求时先检查这个键是否已经处理过:如果处理过,直接返回第一次的结果;如果没处理过,正常执行并记录键。
http
POST /v1/charges
Idempotency-Key: 550e8400-e29b-41d4-a716-446655440000
Content-Type: application/json

{“amount”: 100, “currency”: “usd”}
键的生成应该在重试循环之外,通常用 UUID v4。如果在每次重试时重新生成,幂等性就完全失效了。
Redis SET NX EX:原子抢占,避免并发双重执行
服务端的实现不需要复杂框架。Redis 的 SET key value NX EX seconds 是原子的:只有当 key 不存在时才写入并返回成功,同时设置过期时间防止死锁。
python
import uuid
import redis

r = redis.Redis()

def handle_idempotent(idempotency_key: str, operation):
    redis_key = f“idempotency:{idempotency_key}”
    lock_value = str(uuid.uuid4())

    acquired = r.set(redis_key, lock_value, nx=True, ex=300)
    if not acquired:
        # 已经有人处理过或正在处理;返回首次结果或 409
        existing = r.get(redis_key)
        if existing == b“__completed__”:
            return {“status”: “replayed”}
        return {“status”: “in_progress”}, 409

    try:
        result = operation()
        r.set(redis_key, “__completed__”, ex=86400)
        return result
    except Exception:
        r.delete(redis_key)  # 失败时释放,允许合法重试
        raise
这里有两个容易被忽略的细节。第一,NX 和 EX 必须在同一条 SET 命令里完成。如果拆成 SETNX 再 EXPIRE,进程在两条命令之间崩溃会留下一个永不过期的锁。第二,失败时要用自己的 lock_value 做安全删除(生产环境用 Lua 脚本比较并删除),不能直接 DEL,否则可能误删另一个请求刚刚获取的锁。
Webhook 接收端:验签失败和重复回调,是两件独立的事
Webhook 是“上游主动推给你”的请求,它面临两个不同的问题:这个请求是不是上游发的(验签),以及同一个事件是不是被推了多次(幂等)。验签解决的是安全问题,幂等解决的是重复处理问题,不能互相替代。
验签失败的头号原因:你用了“重新序列化”的 body
HMAC-SHA256 签名是对原始请求体的字节计算的。如果你在 Express 里先用 express.json() 解析了 body,然后把 req.body 对象重新 JSON.stringify 再去算 HMAC,空格、键的顺序、Unicode 转义方式都可能和原始字节不同,签名必然对不上。
正确的做法是在 JSON 解析之前捕获原始 body:
javascript
const express = require('express');
const crypto = require('crypto');

const app = express();

app.post(
  '/webhook',
  express.raw({ type: 'application/json' }),  // 不要用 express.json()
  (req, res) => {
    const rawBody = req.body;  // Buffer,原始字节
    const signature = req.get('X-Signature');
    const timestamp = req.get('X-Timestamp');

    if (!signature || !timestamp) return res.sendStatus(401);

    // 1. 防重放:时间戳必须在容忍窗口内
    const now = Math.floor(Date.now() / 1000);
    const tolerance = 300; // 5 分钟
    if (Math.abs(now - Number(timestamp)) > tolerance) {
      return res.status(401).send('stale timestamp');
    }

    // 2. 对原始字节计算 HMAC
    const expected = crypto
      .createHmac('sha256', process.env.WEBHOOK_SECRET)
      .update(`${timestamp}.`)
      .update(rawBody)
      .digest('hex');

    const expectedBuf = Buffer.from(expected, 'hex');
    const receivedBuf = Buffer.from(signature, 'hex');

    if (
      expectedBuf.length !== receivedBuf.length ||
      !crypto.timingSafeEqual(expectedBuf, receivedBuf)
    ) {
      return res.status(401).send('invalid signature');
    }

    // 3. 验签通过后,再做幂等去重
    const eventId = JSON.parse(rawBody.toString()).id;
    if (!dedupe(eventId)) return res.status(200).send('duplicate');

    res.sendStatus(200);
  }
);
几个关键点:时间戳窗口是防重放的必要条件,5 分钟是常见容忍值;比较签名时用 crypto.timingSafeEqual 而不是 ===,避免时序攻击;express.raw() 必须挂在路由级别,如果全局 express.json() 已经生效,raw body 就拿不到了。
验签通过之后:Webhook 的幂等性靠 event ID,不靠 IP 或时间
Webhook 的重试策略通常由上游控制,同一个事件可能因为你的 5xx、超时或网络抖动被推送多次。接收端必须在验签通过后、处理业务逻辑之前,用事件本身的唯一 ID 做去重。不能靠“同一 IP 短时间内多次请求”来判断,因为上游可能从不同 IP 重试;也不能靠 payload 的哈希,因为合法的事件更新可能产生相似但不相同的 payload。
去重的存储可以是 Redis 的 SET NX(和上面的幂等锁同一个模式),TTL 至少覆盖上游的重试窗口(通常 24 小时到数天)。去重键建议用 webhook:{event_id},而不是原始 payload。
排查工具箱
遇到 API 报错时,先按这个顺序排除,不要直接改代码。
第一步:用 curl -v 看原始 HTTP 交互。 它会把 DNS 解析、TLS 握手、请求头、响应头和响应体的前几行全部打出来。如果看到 Connection reset by peer 或 curl: (35) OpenSSL SSL_connect,问题在网络层而不是配额;如果看到 HTTP/1.1 429 并且有 Retry-After 头,这才是真正的限流。
第二步:用 dig 排除 DNS 问题。 对比默认 resolver 和 8.8.8.8 / 1.1.1.1 的解析结果。如果默认 resolver 返回了一个私网地址或明显错误的 IP,DNS 污染就是根因。
第三步:检查文件描述符和连接数。 ulimit -n 看软限制,lsof -i | grep python | wc -l 或 ss -s 看当前打开的连接数。如果 fd 使用量接近上限,优先修连接复用和响应关闭,而不是调大 ulimit 掩盖泄漏。
第四步:确认连接池配置。 Python requests 的 Session 默认连接池大小有限;如果用 HTTPAdapter,pool_maxsize 要根据并发量设置,但不是越大越好,过大的池会加剧上游和服务端的连接压力。Node.js 的 axios 默认没有连接池概念,每个请求独立建立连接,高并发下同样会耗尽本地端口。
总结:重试是最后一道防线,不是第一道
高可用 API 调用的原则按优先级排列应该是:降级 > 缓存 > 限流 > 幂等 > 重试。重试放在最后,是因为它只能处理“瞬时故障”,不能处理配额耗尽、DNS 污染、连接泄漏或业务逻辑错误。把重试加在一个本身不稳定的调用链上,只是把失败的时间点往后推。
如果你不想在每个调用点重复维护退避参数、Retry-After 解析、幂等键和连接池,或者你需要统一接入 OpenAI、Anthropic 和多家云厂商的 API,我们提供的统一 API 代理服务已经把上述重试、幂等和容灾机制内置在接入层。可以参考站内的《MatataCloud 统一 API 代理方案指南》,了解多上游场景下的配置方式。
关于作者
本文由一名后端/平台工程师撰写,长期负责高并发 API 接入层和第三方回调链路的稳定性。文中报错日志、重试配置和幂等实现均来自生产环境或本地复现,代码片段已在 Python 3.11 + tenacity 9.x、Node.js 20 + axios-retry 4.x 上验证。重试不是银弹,先把 429 和超时拆开看,再决定要不要退避。
- 找AWS代理商防坑指南:揭秘这5个“隐藏条款”,别让代充变成灾难!
- AWS省钱指南:预留实例(RI) vs Savings Plans深度对比,到底怎么买最省钱?(附真实账单测算)
- 避坑指南:彻底解决 API 频繁超时 | 429 报错与 Webhook 重复回调
- 实测复盘:从大厂托管API网关迁移至轻量级反向代理
- 实测避坑:跨云调用API出网流量到底有多贵?一套架构优化方案省下$800/月
- 跨境电商云服务器选型指南:从地域选择到配置推荐的完整决策框架
- 被忽视的AWS隐性成本:8个每月悄悄多花钱的地方
- AWS成本优化实战:一个月账单从$85K降到$58K的完整复盘
- AWS官网直购 vs 通过代理商购买:成本、支付与支持全维度对比
- AWS Savings Plans 使用指南(2026完整版)
- 云端服务器推荐:AWS、Azure、GCP、阿里云深度评测与选型指南

