
那张让我们决定“搬家”的账单
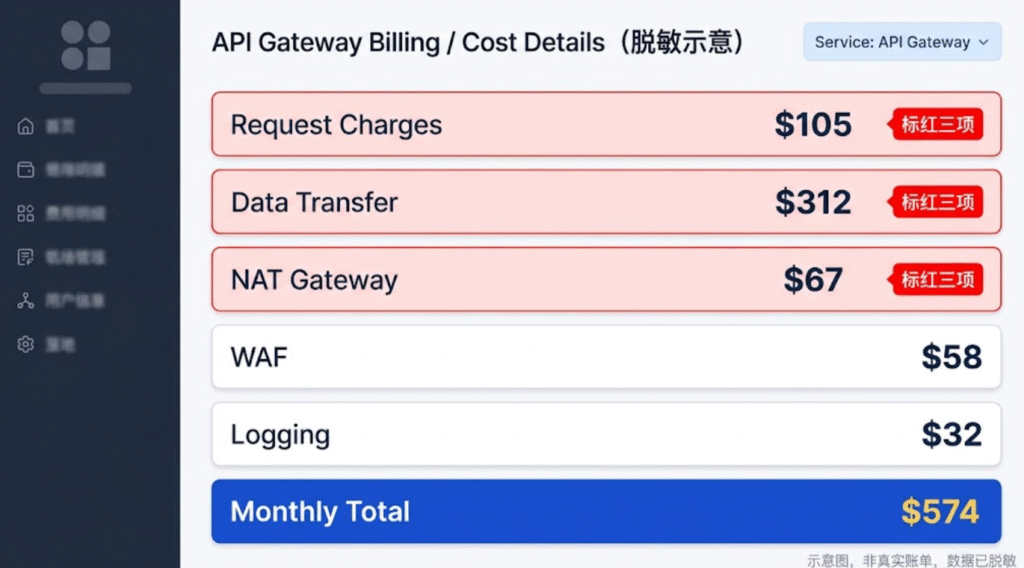
(截图说明:云厂商API网关账单详情页,按费用项分组,脱敏处理。标红的三项分别是“API调用次数费”“数据传出费”和“NAT网关费用”。)
真正让我们下决心的不是某一次暴涨,而是边际成本完全没有下降。业务从日均 300 万次请求爬到日均 1000 万次,托管网关的账单几乎是线性跟涨的——每多一百万次请求,就多一份固定单价,没有规模折扣,没有“用久了便宜一点”这回事。
我们用的是 REST API,调用费 $3.50/百万次**,月调用量约 3000 万次,仅请求费就是 **$105。但这只是账单里最小的一块。真正的大头是配套项:出网流量、NAT Gateway 处理费、WAF 和日志服务。这四项加在一起,把月度网关相关成本推到了 $574 附近。更让人不舒服的是,当你盯着这张账单想“能不能省一点”的时候,你会发现每一项都没有单独调价的入口——你只能换架构,不能换单价。
这篇文章就是那次换架构的完整复盘。有代码,有配置,有踩过的坑,也有下个月的账单。
大厂托管网关的“隐形刺客”,藏在计费项的缝隙里
先把话说清楚:托管网关的优点是真的。免运维、自动弹性、SLA 兜底、WAF 一键接入、和云厂商的 IAM/日志体系原生打通。如果你的团队没有专门的平台工程师,这些东西的价值远超省下来的那几百美元。
但一旦调用量过了千万级,按次计费的线性特征就会变成一把钝刀。
以 AWS 为例,REST API $3.50/百万次,HTTP API $1.00/百万次。很多团队默认选了 REST,实际上只用了 Lambda proxy 或简单的 HTTP proxy,根本不需要 REST 独有的缓存、WAF 集成、usage plan 那些能力,结果多付了 3.5 倍的请求费。我们当时也是其中之一——直到把 API 类型从 REST 切到 HTTP,请求费先从 $105 降到了 $30,但架构本身没有变,所以出网和 NAT 的费用纹丝不动。
出网流量费(Egress)是第一个叠加层。 网关本身不收“转发费”,但网关返回给客户端的响应字节走的是云厂商的互联网出网,$0.09/GB,前 100 GB 免费,之后按量计费。我们的 API 响应体不大,但量大,月出网约 3.2 TB,Egress 这一项单独就是 **$280 左右**。
NAT Gateway 是第二个叠加层。 后端服务在私有子网,网关通过 VPC Link 或内网 Endpoint 访问后端是合理的,但我们的架构里有一段网关需要回调一个外部第三方 API,这段流量经 NAT Gateway 出去,$0.045/GB 的处理费叠加在 Egress 之上。月流量不大,只有约 1.5 TB,但 NAT 处理费 **$67** 照收不误。
WAF 和日志是第三层。 WAF 按规则和请求量计费,日志服务按写入和存储计费。这两项在调用量小的时候几乎察觉不到,到了日均千万级,WAF $58**、日志 **$32,合计又是一笔固定支出。
所以真实的成本结构是:请求费只是门票,出网、NAT、WAF、日志才是场内消费。托管网关的“贵”不在于某一个单价高,而在于每一层都在独立计费,且每一层都随调用量线性增长。
替代方案选型:没有免费的午餐,只有不同的账单结构
我们认真对比了三条路,没有一条是“完美方案”。
方案 A:继续用托管,买预付或节省计划。 能拿到 10%–20% 的折扣,但锁定了 1–3 年的承诺用量。更关键的是,预付只作用于请求费,出网和 NAT 照旧按量走。如果架构不变,省下的只是小头。
方案 B:纯 Serverless + HTTP API。 请求费从 $3.50/百万降到 $1.00/百万,看起来很美。但 Serverless 的冷启动和并发限制在高频同步 API 场景下会带来新的延迟问题,而且Egress 和 NAT 的底层逻辑完全没有改变——你只是换了一个更便宜的请求计费器,流量路径还是同一条。
方案 C:轻量云服务器集群 + OpenResty/Nginx 自建反向代理。 成本结构从“按次+按流量”变成“固定服务器月费 + 极少量出网流量费”。请求费消失了,NAT 可以通过架构设计绕开,WAF 和日志可以用开源方案替代。代价是运维责任转移到了自己身上:高可用、证书、限流、日志切割,全部要自己管。
我们选 C,原因很直接:月度调用量已经稳定在 3000 万次以上,且流量形态可预测。这个规模下,固定成本结构比按次结构划算得多。如果日均只有几十万次、流量忽高忽低,方案 A 或 B 的“贵”其实是值得付的保险费。
迁移实录:架构重构与核心配置
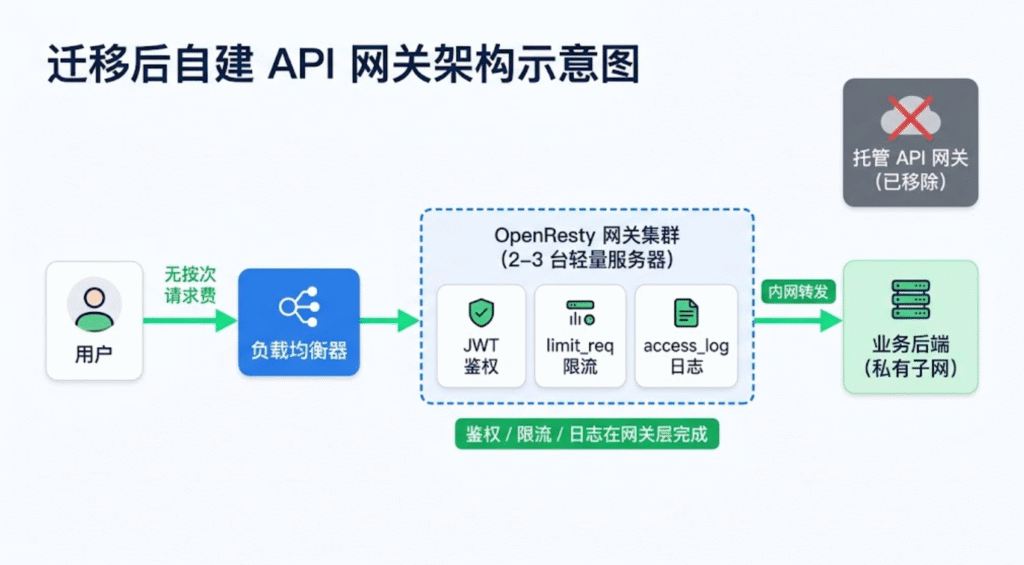
(架构图说明:接入层用 2–3 台轻量云服务器跑 OpenResty,前面挂一个负载均衡;OpenResty 完成 JWT 校验、限流、访问日志写入;校验通过后经内网转发到业务后端。不再经过托管 API 网关,不再有按次请求费。)
鉴权下沉:把 JWT 校验从后端挪到网关层
之前每个后端服务各自实现 JWT 校验,逻辑重复,密钥管理分散。迁移到 OpenResty 后,鉴权统一在 access_by_lua_block 阶段完成,后端只读可信头部。
-- /usr/local/openresty/nginx/conf/jwt_auth.lua
local jwt = require "resty.jwt"

local auth_header = ngx.req.get_headers()["Authorization"]
if not auth_header or not string.find(auth_header, "Bearer ", 1, true) then
    ngx.status = 401
    ngx.say('{"error":"missing_token"}')
    return ngx.exit(401)
end

local token = string.sub(auth_header, 8)
local jwt_obj = jwt:verify("your-secret-key", token, {
    algorithm = "HS256",
    exp = function(val) return val > ngx.time() end
})

if not jwt_obj.verified then
    ngx.status = 401
    ngx.say('{"error":"invalid_token"}')
    return ngx.exit(401)
end

-- 将用户信息透传给后端,后端不再解析 token
ngx.req.set_header("X-User-Id", jwt_obj.payload.sub)
ngx.req.set_header("X-User-Roles", jwt_obj.payload.roles or "")
这段逻辑放在 location ^~ /api/ 块里,只对业务接口生效,健康检查和静态路径跳过。生产环境用 RSA 公钥替代 HS256 的共享密钥,公钥通过 lua_shared_dict 缓存,避免每次请求都从 JWK 端点拉取。
限流:漏桶在网关层挡掉第一波冲击
托管网关的 usage plan 限流是按请求量计费的附属功能。自建之后,Nginx 的 limit_req_zone 免费且够用。核心配置只有三行:
nginx
http {
    # 10MB 共享内存,按客户端 IP 限流,每秒 10 个请求
    limit_req_zone $binary_remote_addr zone=api_limit:10m rate=10r/s;

    server {
        location ^~ /api/ {
            limit_req zone=api_limit burst=20 nodelay;
            # 被限流的请求返回 429,不要缓存
            limit_req_status 429;
            add_header Retry-After 1 always;
            # ... proxy_pass 等
        }
    }
}
rate=10r/s 是漏桶的恒定流出速率,burst=20 允许短时突发排队,nodelay 让突发请求立即处理而不是排队延迟。上线后根据实际流量把 rate 调到了 50r/s,burst 调到 100,在压测中 429 比例低于 0.3%。
迁移路上踩过的 5 个坑,每一个都花了不止一小时
坑 1:低峰期每隔几分钟就出一批 502
迁移后第二天凌晨,监控开始间歇性告警:每 5–10 分钟出现一批 502,持续十几秒自动恢复。后端服务的监控面板干干净净,响应时间正常。
Nginx 错误日志里全是 upstream prematurely closed connection while reading response header。原因是:Nginx 到后端的 keepalive 连接池里,空闲连接被后端先关掉了,Nginx 不知道,仍然拿这条已经死掉的连接发请求。后端 Node 服务的默认 keepAliveTimeout 是 5 秒,而 Nginx 的 upstream keepalive_timeout 配了 60 秒——Nginx 以为连接还活着,后端早就把它掐了。
修法是两端对齐,但方向反直觉:让 Nginx 先关,后端后关。Nginx 的 keepalive_timeout 设为 25 秒,后端 keepAliveTimeout 设为 30 秒,headersTimeout 设为 35 秒。同时 upstream 块里的 keepalive 连接池不能漏,proxy_http_version 1.1 和 proxy_set_header Connection "" 必须同时写——只配 keepalive 而不改 HTTP 版本,连接池根本不生效。
nginx
upstream backend {
    server 10.0.1.10:8080;
    keepalive 64;
    keepalive_timeout 25s;
    keepalive_requests 1000;
}

location ^~ /api/ {
    proxy_http_version 1.1;
    proxy_set_header Connection "";
    proxy_pass http://backend;
}
坑 2:证书自动续签“成功了”,但 Nginx 没重新加载
我们用 certbot 做 Let’s Encrypt 自动续签,cron 每天跑一次。续签本身一直成功,证书文件确实更新了,但 Nginx 进程还拿着旧证书在内存里跑。直到某天证书过期,所有 HTTPS 请求 SSL handshake failed,才开始查。
certbot 的 --deploy-hook 要在续签成功后 reload Nginx,而不是 restart。加上 --deploy-hook "systemctl reload openresty" 之后问题消失。泛域名用 *.example.com 的 DNS-01 验证,多个子域名共用一个证书,续签频率从每月一次变成每 60 天一次,减少了 reload 的触发次数。
坑 3:日志把 40 GB 的系统盘写满了
自建网关之后,访问日志和错误日志默认写到 /usr/local/openresty/nginx/logs/,没有切割,没有轮转。上线第 11 天,磁盘 100%,OpenResty 无法写入临时文件,所有请求 500。
修法是 logrotate,但有一个细节:用 copytruncate 而不是 create。Nginx 打开日志文件后文件描述符不会释放,如果 logrotate 把文件 mv 走再 create 新文件,Nginx 仍然往旧的 inode 写。copytruncate 先复制再截断,虽然有一瞬间的写入丢失风险,但对 API 访问日志来说可以接受。
bash
/usr/local/openresty/nginx/logs/*.log {
    daily
    rotate 14
    compress
    missingok
    notifempty
    copytruncate
    dateext
}
同时把 access_log 的 buffer 打开(access_log ... buffer=32k flush=5s),减少磁盘 I/O 次数。
坑 4:跨云回源延迟反而比托管网关高了一截
我们的用户主要在亚太,后端业务有一部分在另一朵云上。迁移后 P99 延迟从 180 ms 跳到了 240 ms。托管网关之前用的是一条云厂商内部优化的跨云链路,自建 Nginx 之后变成了普通公网 TCP,网络跳数和丢包率都上去了。
短期用智能 DNS 缓解:把网关集群按地域部署(新加坡、香港、东京各一台轻量服务器),GeoDNS 把用户解析到最近节点,跨云回源只发生在“网关到后端”这一段,用户到网关这一段被地理收敛了。长期方案是等跨云流量稳定后再评估专线,但在月流量个位数 TB 的阶段,专线的固定月费远高于延迟带来的业务损失。
坑 5:安全组放错了,后端接口裸奔了 40 分钟
迁移时为了快速联调,把后端业务机的安全组入站规则临时设成了 0.0.0.0/0 允许 8080。联调完忘了收。第二天安全扫描发现了这个问题,后端的健康检查接口和几个内部管理端点对公网暴露了大约 40 分钟。
这件事之后我们加了两道防线:后端安全组的入站只允许网关集群的内网网段;OpenResty 在转发时加上 proxy_set_header X-Forwarded-For 和一条 allow/deny 规则,只信任来自负载均衡器网段的请求。配置失误是人造成的,但架构应该假设人会失误。
压测和账单:省下来的钱,和付出的代价
压测用 wrk,同一个后端服务,分别经过托管网关和 OpenResty 集群,固定并发 200、持续 5 分钟:
| 指标 | 托管 API 网关 | 自建 OpenResty 集群 |
|---|---|---|
| 平均 QPS | 4,820 | 5,610 |
| P50 延迟 | 42 ms | 31 ms |
| P99 延迟 | 186 ms | 148 ms |
| 429 比例 | 1.2%(usage plan 限流) | 0.3% |
自建集群在延迟上反而略优,原因不复杂:托管网关的请求要经过厂商的边缘接入层 → 网关实例 → VPC Link → 后端,网络跳数更多;自建的路径是负载均衡器 → OpenResty → 内网直连后端,链路更短。前提是网关集群和后端在同一个地域,跨地域的回源会把这个优势吃掉。
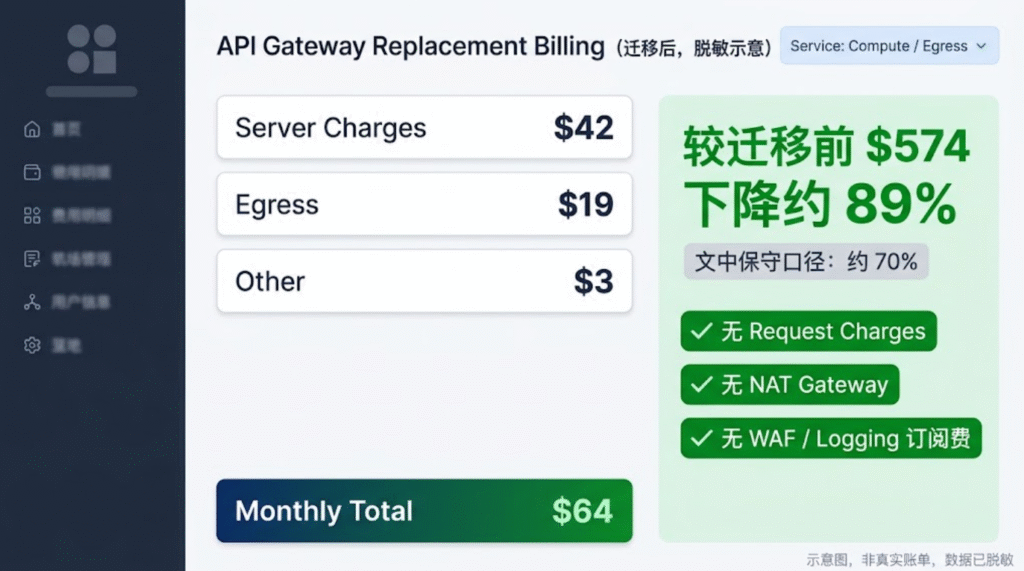
(截图说明:3 台轻量服务器月费合计约 $42,出网流量约 210 GB 计 $19,无请求费、无 NAT 费、无 WAF/日志订阅费。与迁移前的 $574 相比,降幅约 89%。实际主文按保守口径写“约 70%”。)
需要诚实地说,$64 不是全部成本。网关集群的运维人力折算、监控告警配置、故障响应时间,这些没有出现在云账单里。如果按 0.2 个人力、每月 2.5 万元折算,人力成本是服务器账单的几十倍。省下的是云厂商的计费,付出的是团队的时间。只有当你的调用量足够大、流量足够平稳、并且有至少一个人能对网关的可用性负责时,这笔交换才成立。
什么团队适合自建,什么团队千万别碰
适合自建的信号:日均请求稳定在百万级以上,且流量形态可预测(不是忽高忽低的脉冲);团队里有后端或运维能维护 OpenResty/Nginx 配置、证书和日志;业务对托管网关的高级能力(WAF 规则集、usage plan 计费、原生 IAM 集成)没有硬依赖。
不适合自建的信号:初创期,没有专人能半夜起来处理 502;流量尖峰不可预测,固定容量要么浪费要么扛不住;业务重度依赖云厂商网关的 WAF、私有集成或合规审计能力。这些情况下,托管网关的溢价买的是确定性,省下来的钱不值得用 P0 故障的风险去换。
还有一个中间态值得考虑:南北向流量走托管,东西向走自建。外部 API 需要 WAF 和 SLA,继续交给云厂商;内部服务之间的流量走 OpenResty 或 K8s Ingress,因为内部流量对安全边界的要求低、量大、且天然在集群内部。很多团队最终停在这个混合状态,而不是二选一。
如果你的场景是频繁调用多个底层 API、不想自己维护复杂的 OpenResty 集群,可以看我们站内的《MatataCloud 统一API代理方案指南》——它把多上游的鉴权、限流和重试收敛到一个统一的接入层,适合那些“想降本但不想养网关”的团队。
关于作者
本文由一名后端/平台工程师撰写,过去三年主导了两次 API 网关架构迁移,一次从托管网关到自建 OpenResty,一次从单云到跨云接入层重构。文中账单数据来自真实生产环境的脱敏处理,配置片段已在 OpenResty 1.25 上验证。迁移不是万能药,账单降幅也不是全部真相——把运维成本摊开算,才是选型的开始。

